Demotif:用语音编曲
小时候学过一点基础乐理,抱着吉他弹过几首曲子,之后尝试过在 FL Studio 里实际自己做过几首曲子。自己动手玩过之后,越发觉得传统编曲软件对新手还是太重了,脑子里明明有一段旋律或者大概的律动,落到软件里却要跟配器、音色插件和混音路由死磕半天。
等到 AI 音乐生成火起来,我满怀期待去试了一圈,发现它跟现在的视频生成工作流比起来还显得很不成熟。视频生成领域早就演进出了成熟的画布系统,分镜、关键帧、角色资产和局部重绘全都能在画布上拆开摆弄。但反观 AI 音乐这边,绝大多数产品还停留在给一句提示词抽卡吐一首双声道成品的黑盒阶段。
哪怕懂点乐理、知道副歌前四小节该怎么加鼓,面对一段混死的音频波形也无从下手,想留着主唱单独换掉底下的鼓点,或者微调一下音符,在对话框里根本使不上劲。于是乎,我也顺势尝试了像 Suno Studio 这样的 AI DAW 产品。此外,目前的各种大模型也并不擅长编曲,但像是 YuE2 这种先写谱再出声的开源模型,生成的谱子就非常不错。
既然音乐缺少像视频画布那样直观、可拆解、可局部干预的交互层,干脆以多轨时间轴为画布,把符号谱面生成、分轨工程和实时语音串起来,做一个能让新手和创作者在浏览器里像跟制作人聊天一样改歌的 Web DAW,于是我动手写出了 Demotif。
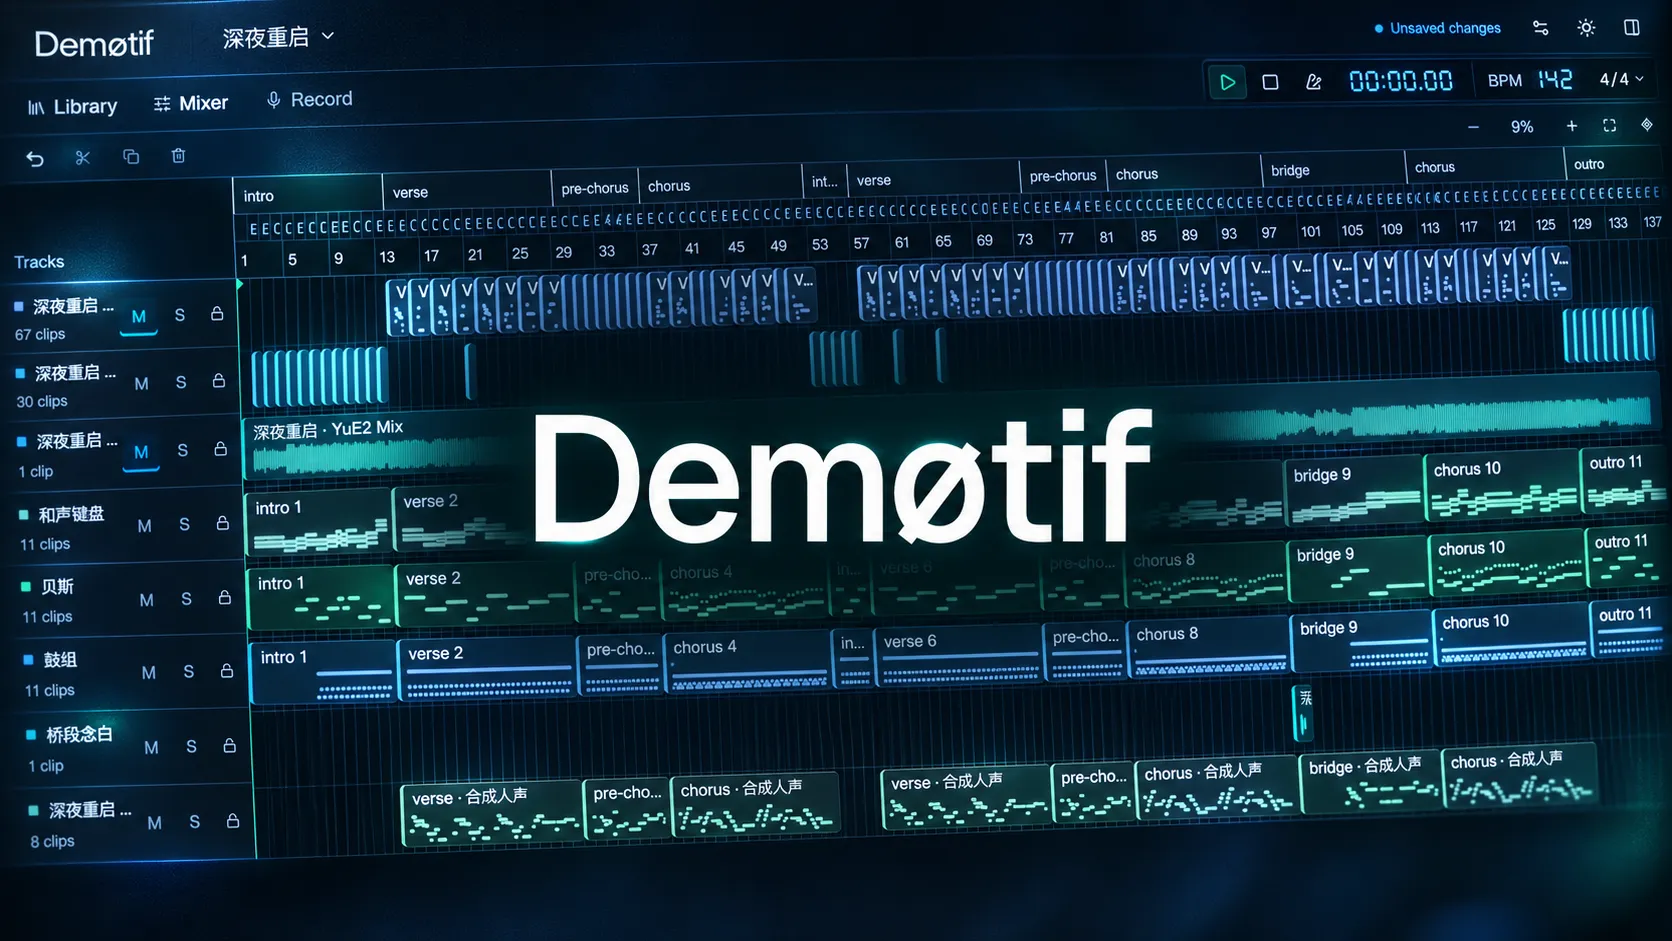
什么是 DAW
平时说的 DAW 也就是数字音频工作站,核心干的就是录音、音符编排、混音和母带导出这几件事。打开任何一款主流桌面 DAW,面对的都是一套围绕时间轴、轨道、片段和调音台搭起来的工程结构。
拿时间轴和轨道来说,工程在横向上按小节、拍号和曲速对齐时间网格,也可以切到秒数标尺看绝对时间;纵向上则排列着不同类型的轨道。音频轨用来放录制的人声、吉他干声或者现成的采样波形,MIDI 轨和乐器轨则存着音高、力度、起止位置和控制包络等符号化指令,本身不发光发热,得靠挂载虚拟乐器或采样器才能算出声音。除了这两类基础轨,混音时还会建总线轨、编组轨和发送轨,像是把所有鼓件汇总到一条 Drum Bus 上统一做动态压缩,或者把人声通过 Send 推给一条混响轨,既省算力又能保证空间感一致。
轨道上摆放的一个个方块通常叫作 clip 或者 region。在 FL Studio 这类偏 Pattern 逻辑的工作站里,可以先在 Channel Rack 的步进音序器上给底鼓、军鼓和踩镲点出一组十六分音符的循环节奏,再把这段 Pattern 作为 clip 铺到 Playlist 的时间轴上重复复用。到了 Cubase 或 Ableton Live 这类偏线性时间轴的软件里,双击一段 MIDI clip 就能展开钢琴卷帘或者专用的鼓编辑器,纵轴对应鼓件映射或八度音高,横轴对应拍子落点,底部还能拉出每个音符的打击力度。如果是音频 clip,则支持非破坏性的切分、滑移、淡入淡出和时间伸缩,改的只是外层片段对底层音频源文件的起始偏移与截取长度,原文件分毫未损。
声音从轨道发出来之后,就进入了信号路由和混音台。每条轨道的插入槽可以串联挂载各种音频效果器,先过均衡器切掉低频杂音,再进压缩器压住动态峰值,顺道挂个失真或合唱塑形,经过通道推子调整音量和声像位置后,最终汇入主输出总线。如果希望副歌进场时合成器滤波器的截止频率慢慢打开,或者主唱某一个尾音的混响湿度突然拉大,还可以在轨道下方展开包络线画自动化控制曲线。
回到开头那个四小节加鼓的场景,只要主唱已经单独躺在一条音频轨上,新增一条鼓轨去画四小节的 MIDI 鼓点,主唱和鼓在工程里就是两条完全正交的信号流,怎么改鼓点、换鼓组音色甚至重写末尾的过门加花,都碰不到主唱一根毫毛。传统 DAW 的控制粒度细到了每一颗音符的微秒级偏移和每一个采样点的增益,代价就是使用者脑子里得先装着配器法、节奏型和混音路由,面对空白的步进网格知道底鼓踩在一三拍还是切分音,军鼓怎么接,过门怎么排才不会抢了主唱的气口。
AI 音乐生成
正因为手动排音符和调混音门槛不低,端到端的 AI 音乐生成模型才会让人觉得惊艳。给一段文本提示词描述曲风、配器、情绪和曲速,再附上分好主副歌段落的歌词,模型几十秒就能交出一首编配完整、带人声演唱的立体声成曲。
要理解为什么生成整首歌容易、局部换鼓却难如登天,得先看当前音乐生成模型在底层是怎么表征和合成声音的。市面上主流的技术路线大致能分成波形建模与符号建模两大派,中间还演化出了把两者捏在一起的混合架构。
一是基于离散音频码本的自回归语言模型,早期代表有 MusicLM、MusicGen,后续的开源方案 YuE 也延续了这条脉络。这类模型先训练一个类似 EnCodec 或 SoundStream 的神经音频编解码器,通过残差向量量化把连续的音频波形压缩成多层离散的声学 token,同时借助预训练语义模型提取表征乐理结构与旋律走向的语义 token。生成音乐的过程就变成了训练 Transformer 按时间步预测下一个 token,先由文本生成粗粒度的语义骨架,再逐级解码出高频声学细节。自回归路线很擅长把握长程的段落起伏、主副歌情绪推进和人声咬字,但因为声学 token 把所有乐器和人声都压在了同一套隐空间序列里,天然产出的是混好的立体声。
二是基于连续潜在空间的扩散模型与流匹配模型,代表作包括 Stable Audio Open、AudioLDM 2 以及 ACE-Step 等。它们用变分自编码器把高采样率音频或是梅尔频谱图压缩成连续的潜在向量,再用 Diffusion Transformer 或 Flow Matching 在潜在空间里从高斯噪声逐步去噪还原出整段音频。扩散架构支持并行解码整个时间窗口,不仅推理速度快,而且天生适合做时域上的局部掩码重绘,也就是常说的音频 Inpainting,还能方便地注入时长、拍速和参考音频特征。
三是符号音乐生成与两阶段混合模型。纯符号模型直接输出 MIDI 事件序列、MusicXML 或 ABC 记谱文本,音符和轨道从出生起就是分开的,只是光有谱面没有声音,还得靠音源插件或神经合成器渲染。把符号规划和声学合成结合起来的代表就是 YuE2,用显式的文本乐谱充当思维链中间态,先写谱再唱曲。
主流模型与接口
放到实际开发和产品调用的场景下,不同厂商把这些底层能力封装成了形态各异的工具与接口,各自的侧重点、上下文输入方式和编辑粒度差异明显。
Suno 主打高完成度的人声成曲与商业工作流闭环,推出了 MCP Beta 协议支持,授权后能直接从兼容的智能体客户端触发歌曲生成并写入账户曲库,同时提供公开的 C2PA 接口用于校验生成音频的溯源签名,并在网页端编辑器内集成了 Replace Section 按时间区间重绘段落。
ElevenLabs 的 Eleven Music 则面向开发者开放了标准化的 REST 接口,核心的 Compose 端点除了接收自由文本 prompt,还支持传入结构化的 composition_plan。在 Music v2 与 v2.5 里,这份编曲计划允许按时间顺序声明多个段落块,为每个块单独指定歌词、曲风标签与精确时长。针对局部修改,其 inpainting 能力支持从云端曲库或上传音频里锁定若干时间切片原样保留,只把其余区间交给模型重绘,生成块还能附带最长 30 秒的音频片段作为条件引导,配合 Audio Reference 实现对参考音频音色与律动的迁移。
Google 在 Gemini API 的 Interactions API 下提供了 Lyria 3 Clip 与 Lyria 3.5 两款模型,前者专攻 30 秒的高质量音乐切片,后者负责生成带完整段落结构的全长歌曲,并在响应体里一并返回带时间戳的歌词与段落标记,方便上层应用直接对齐时间轴;面向企业级云环境则通过 Gemini Enterprise Agent Platform 提供独立的 Lyria 模型服务。
如果把视野拉宽到开源社区与学术界,专门做分轨生成或长程控制的方案也在补齐拼图。Meta 的 MusicGen-Style 与字节跳动的 StemGen 探索了给定已有音轨作为上下文、逐轨生成新声部伴奏的路径;基于扩散架构的 Diff-A-Riff 等模型也专门针对已有混音补录单轨乐器做了优化。
| 方案与模型 | 核心技术路线 | 生成交付物 | 时间与结构控制 | 局部与分轨编辑能力 |
|---|---|---|---|---|
| Suno (v4 / Studio) | 端到端声学大模型 + 多轨工作台 | 立体声成曲、分离分轨、单轨音频与 MIDI clip | 歌词段落标记、时间轴区间选定 | 区间重绘 (Replace Section)、算法分轨 (Stem Separation)、局部补轨 |
| Eleven Music (v2 / v2.5) | 结构化编曲规划 + 条件声学合成 | 立体声成曲与分段音频 | composition_plan 块级时长与风格定义 |
时域切片保留与重绘 (Inpainting)、30 秒音频条件引导、参考音色迁移 |
| Google Lyria (3 Clip / 3.5) | 端到端声学生成 + 结构元数据输出 | 30 秒切片或全长立体声成曲、结构化歌词标记 | 提示词控制、返回段落与歌词时间对齐信息 | 侧重整段或切片生成,无原生多轨工程状态 |
| MusicGen / Stable Audio | 自回归 RVQ 码本 / 潜在扩散 Transformer | 器乐片段或立体声背景音乐 | 文本提示、旋律色度图引导、精确秒数控制 | 支持首尾续写与时域掩码重绘,声部混合在同一波形内 |
| YuE2 | Symbolic CoT (ABC 记谱规划 + 声学条件渲染) | 可读 ABC 乐谱文本 + 立体声混音成曲 | 小节线、拍号、调号、和弦进行与段落标签 | 生成前可精确编辑文本音符与和弦,生成后可解析为独立 MIDI 轨与混音轨 |
回到那四小节加鼓的难题上,端到端声学模型为什么在细改时总让人觉得隔靴搔痒,看一眼表格里的交付物就明白了。直接生成的双声道立体声文件里,主唱、吉他、贝斯和鼓的声波在每个采样点上都已经线性叠加并经过了母带动态处理。想用 Eleven Music 的 Inpainting 或者 Suno 的 Replace Section 把副歌前四小节重画一遍,模型确实能把四小节之外的波形原封不动留住,可一旦进入这四小节的掩码区间,原区间里的主唱和背景鼓点会被一起抹掉重算,很难做到主唱气息咬字纹丝不动而只把底下的鼓抽换掉。就算原本的四小节刚好是纯人声清唱,我们用外部工具在上面硬叠一条新生成的鼓轨,两段已经做过响度最大化处理的立体声撞在一起,也很容易触发总线削波或者让低频糊成一团。
混合工作台与后处理分轨
既然单张网页生成框改不动细节,把生成模型塞进传统多轨时间轴就成了顺理成章的演进方向,Suno Studio 2.0 就是这类生成式 DAW 的代表。它在一个工作台里同时摆上了多轨时间轴、音频轨、MIDI 轨、钢琴卷帘、包络自动化和内置效果器链,底部则留了一个 Chat Bar。当工程里已经有了一条独立的主唱轨时,可以直接在聊天框里用自然语言让它在副歌前四小节生成一段鼓点音频或 MIDI clip 放到新轨道上,不满意再点开钢琴卷帘手动挪两颗军鼓的位置。
那如果手头拿到的就是一首已经混缩好的单文件成曲,怎么把它拆开放进多轨工程里?Suno Studio 2.0 给出的解法是内置 stem separation,也就是音乐源分离技术。这类算法(工业界常见如 Demucs、HTDemucs 或 MDX-Net 架构)结合时域卷积与频谱 Transformer,从混合波形的时频图里逆向估计出人声、鼓、贝斯和其他伴奏四个乃至更多独立声部的波形,行业里统称为 stems。
分轨提出来之后,每条 stem 各自占一条音频轨,这时候确实可以单独拉低原鼓轨的推子,或者把那四小节的原鼓切掉静音,再换上新生成的鼓 clip。不过从音频工程的角度细究,后处理分轨终究是在做盲源分离的逆问题求解:一是频段高度重合的地方容易留下串音或相位伪影,像是军鼓高频瞬态和人声齿音撞在一起时,抽掉鼓轨常常会让主唱听起来发虚或带点水声;二是分离出来的 stem 依然是渲染定型后的扁平音频波形,上面原本挂着的混响尾音已经焊死在波形里了,更无法逆向还原出干净的干声切片、可拖拽的 MIDI 音符对象或者合成器插件的旋钮参数。
符号化中间态与 YuE2
后处理分轨是在成曲之后往回拆,另一条截然不同的思路则是把结构化放到生成声音之前,在模型动嘴唱歌之前先让它把乐谱交出来。YuE2 论文提出的 symbolic CoT(符号化思维链)走的就是这条路,开源仓库里也把这套两阶段管线拆得很清楚:第一阶段模型不碰任何声学波形,专门根据提示词和歌词规划出一份纯文本的 ABC 记谱文件;第二阶段再以这份 ABC 谱面作为强条件约束,驱动声学模型渲染出最终的立体声混音。
之所以选 ABC 记谱法而不是二进制的 MIDI 文件或冗长的 MusicXML,是因为 ABC 天然就是一套高信息密度的纯文本领域特定语言,极其契合大语言模型的 token 预测习惯。一份标准的 ABC 谱面在文件头里用单字母字段声明曲目元数据:M:4/4 定义四四拍,L:1/8 设定默认音符时值为八分音符,Q:1/4=120 锁定曲速为每分钟 120 拍,K:C 标明 C 大调。到了正文部分,前置的和弦符号(如 Am、F)代表当前拍的和弦进行,大小写字母 C D E F G A B 配合单引号或逗号表示不同八度的音高,后面跟着数字代表时值倍数,竖线 | 则是天然的小节分界线,多声部还能通过 V:1、V:2 拆出独立的人声旋律轨与器乐伴奏轨。
有了这层显式的文本中间态,AI 音乐生成就不再是一锤子买卖的黑盒。一方面,程序可以用确定性的解析器把 ABC 文本直接翻译成 DAW 里的拍号、小节网格、和弦标记以及一条条带具体音高和时值的 MIDI clip;另一方面,人在听歌之前就能直接改谱,就副歌前某一小节而言,可以直接把和弦从 C 改成 Am,或者把某句旋律的落音往上提一个全音,再把改好的 ABC 喂给第二阶段去渲染音频。
当然,把符号层和声学层分开之后,两边的数据边界也得拎清楚。ABC 谱面记录的是拍号、和弦与主干旋律这套音乐骨架,而歌手的音色质感、换气口、咬字细节、鼓组采样的瞬态冲击力以及全曲的空间混响,全都发生在第二阶段的神经网络声学合成里。这就带来了两个很有意思的工程现象:一是在重跑第二阶段渲染时,哪怕只改了输入 ABC 里的一个和弦符号,神经网络在全局注意力机制下重算出来的整首音频,其具体的演奏呼吸感和局部混音细节也会跟着发生轻微浮动;二是当我们把同一次生成出来的立体声混音和 ABC 谱面同时导入进本地 DAW 工程后,轨道上的 MIDI 音符和那条立体声混音波形就已经解耦成了两份独立资产,用鼠标在钢琴卷帘里把一颗 MIDI 音符往上拖高三度,本地合成器弹出来的预览音高立刻变了,但旁边躺着的那条静态 WAV 混音文件显然不会跟着鼠标实时重唱一遍。想清楚这层解耦关系,才能设计出合理的混合编曲工作流。
Demotif 的工程设计
摸清了传统 DAW 的数据模型、端到端声学接口的局限以及 YuE2 符号思维链的特性之后,Demotif 的定位就非常清晰了:以浏览器内的多轨非破坏性 DAW 为底座,把 YuE2 的两阶段谱面与音频生成管线接进来,再在顶层架设一个看得见工程上下文、能用实时语音边听边聊边改工程的 AI Producer。
谱面与混音双轨导入
在生成管线的对接上,Demotif 把 YuE2 的能力拆成了三种可按需调用的任务模式,并且支持将产出物无损装填进工程轨道,随时接着裁剪、切片、混音或导出标准 WAV。
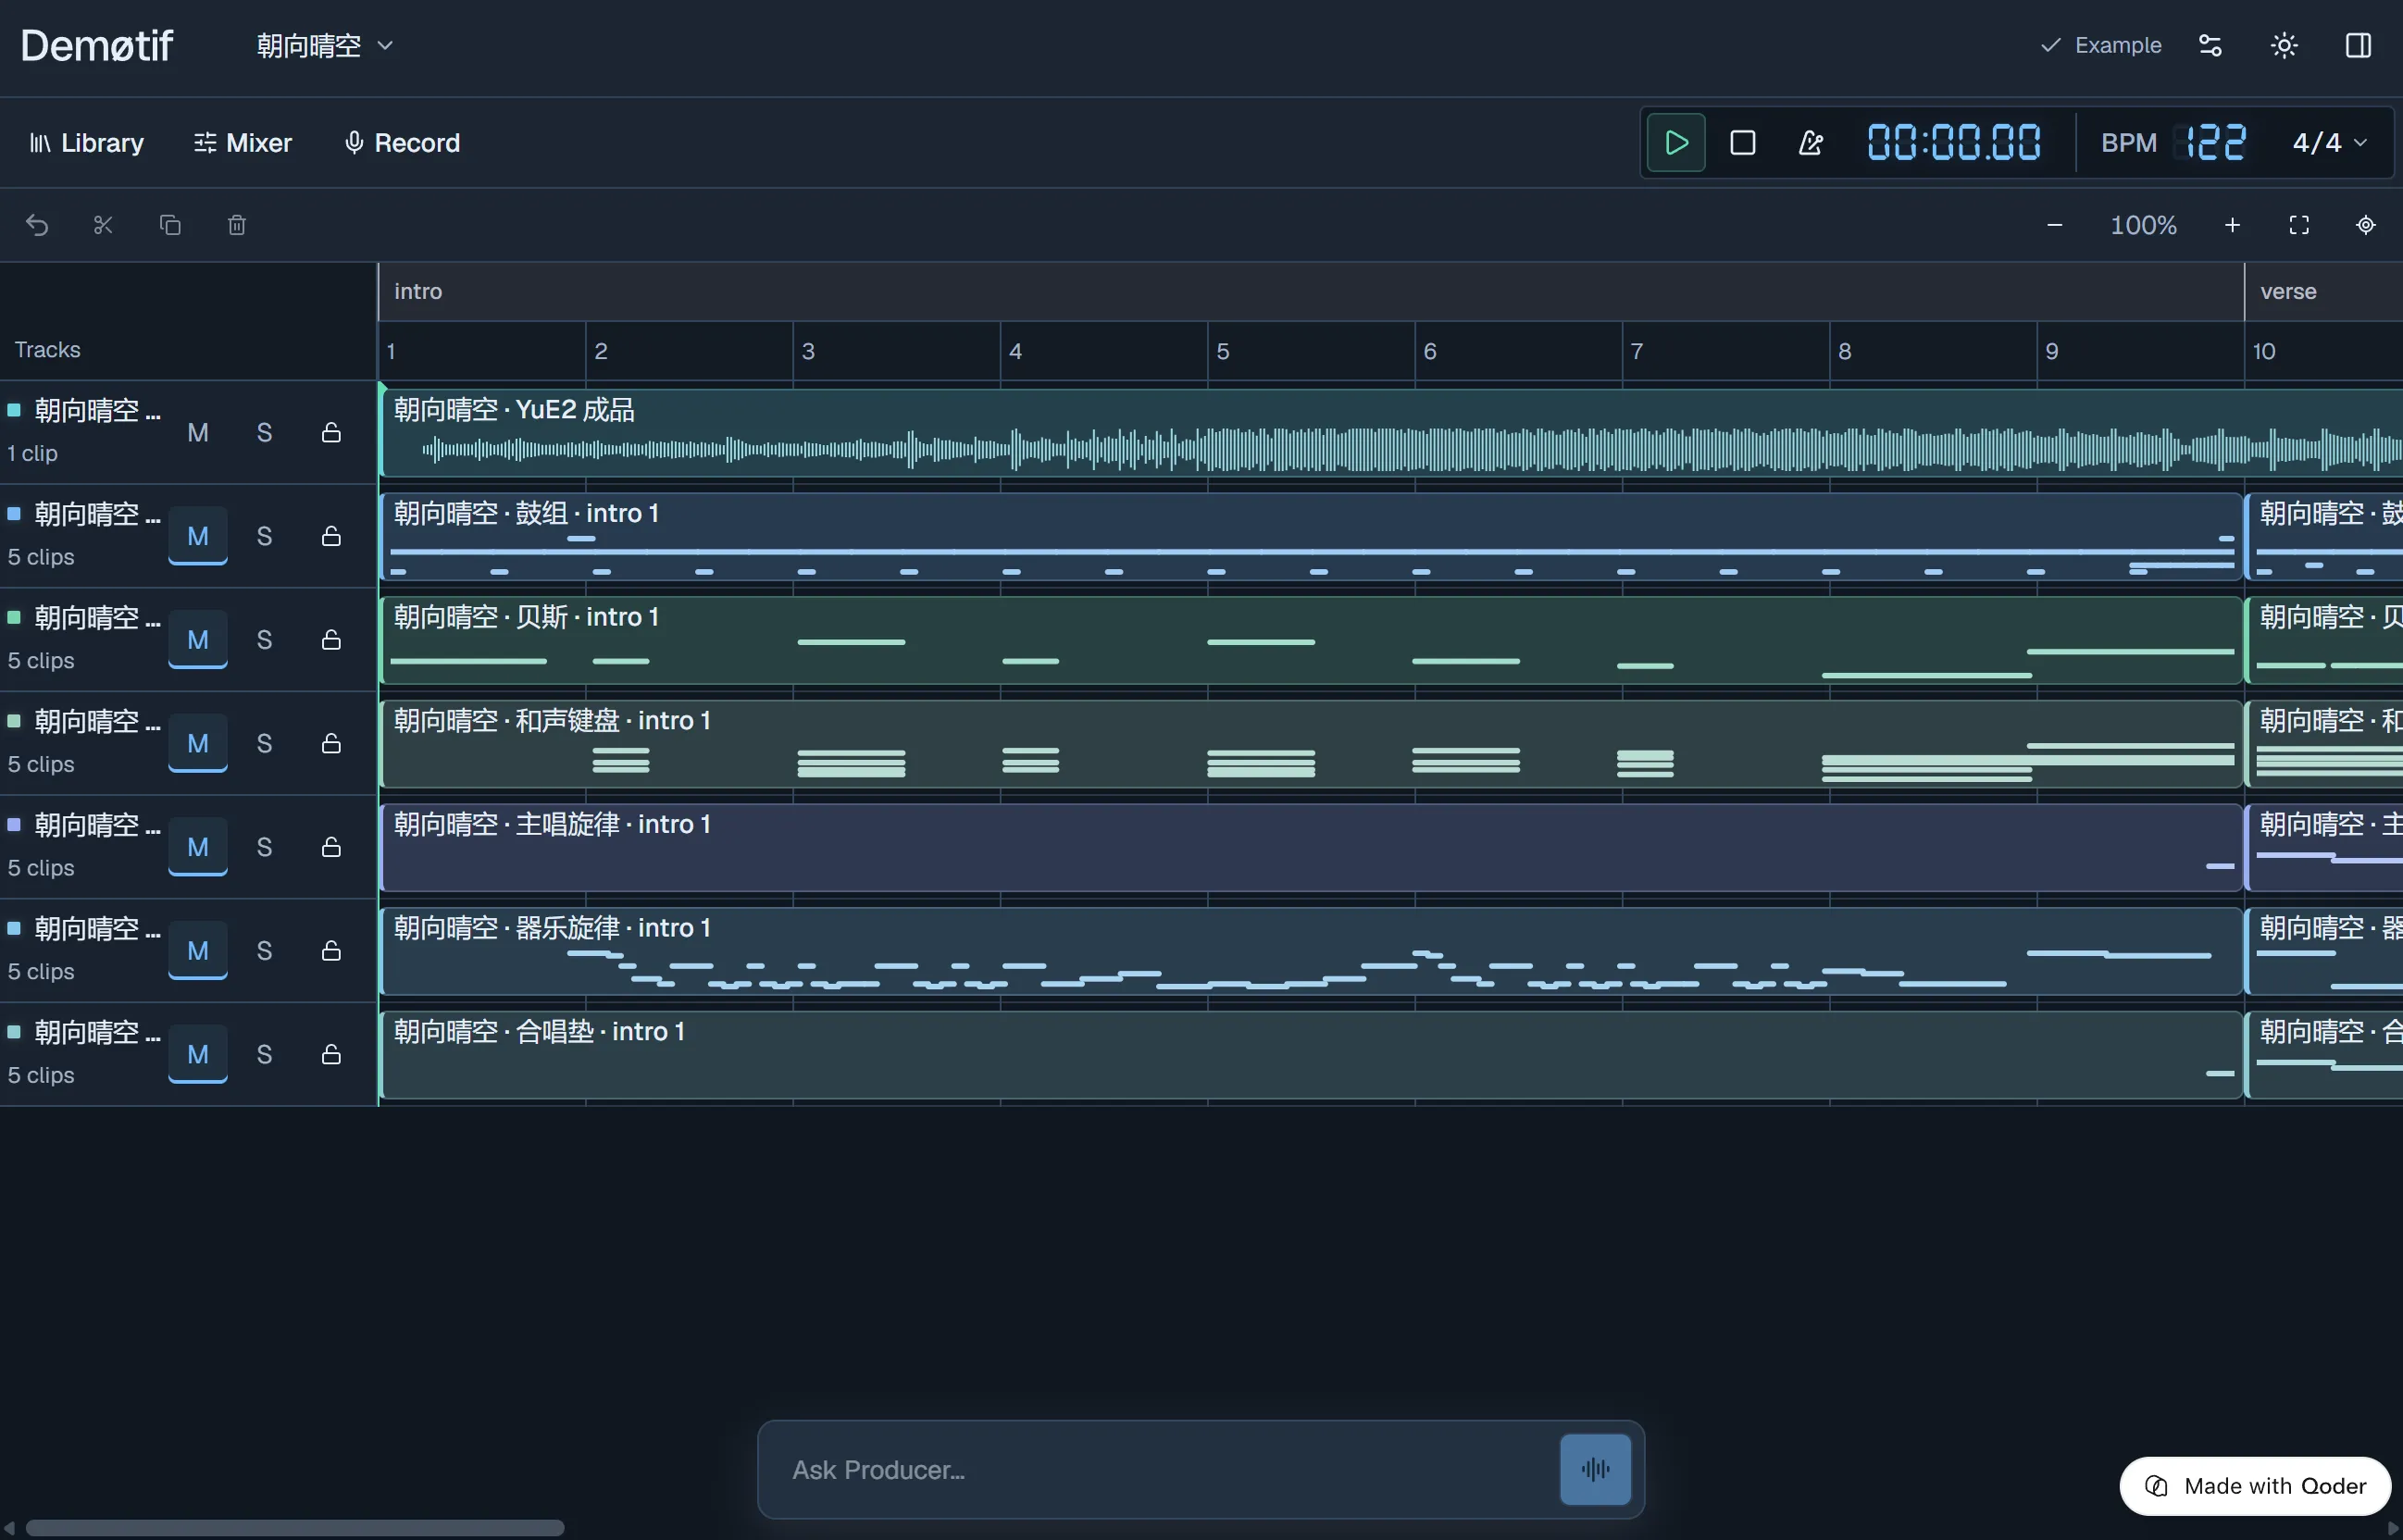
plan_project_score(仅规划谱面):只运行第一阶段符号生成,快速拿回整首歌的 ABC 记谱文本并直接解析成工程里的多条 MIDI 轨道与段落结构,适合在动用重算力渲染音频前先敲定和弦走向与主旋律。render_arrangement(谱面与混音同出):完整跑通两阶段管线,一次性取回生成的立体声混音文件以及驱动这次渲染的原始 ABC 谱面,实现声学成曲与符号骨架的同步落轨。render(仅导入混音):将渲染好的立体声成曲直接作为单条音频轨挂入当前工程时间轴。
当服务端拿到一份 ABC 记谱文本后,内置的解析器会先读取文件头的 M:、Q:、K: 字段来同步或校验工程的拍号与基准曲速,接着将各个声部的人声旋律与器乐旋律严格按照小节线边界切分整理,计算每个音符在工程中的精确拍数起点(beat)与持续拍长(duration),转换成 DAW 时间轴上可独立编辑的音符 clip,同时把段落标记(Section Marker)与和弦进行一并锚定到时间轴顶部的标尺上。
这里有一个很关键的混音防冲突设计:当通过 render_arrangement 把立体声混音和解析出的旋律轨同时导入工程时,系统会将解析出来的 MIDI 旋律轨默认设为静音(Mute)。原因很简单,如果让浏览器内置的 Web Audio 合成器按谱面干巴巴地弹出正弦波或三角波音符,跟旁边包含饱满配器和真实人声咬字的立体声混音叠在一起同时放,听感会非常奇怪。平时播放时直接听混音轨的完整效果;需要核对某几小节的旋律音高、或者想拿这段 MIDI 去驱动其他音色时,再单独把某条旋律轨点亮独奏(Solo),谱面骨架与成曲波形各司其职。
在算力调度与运行时架构上,前端日常的多轨对齐播放、循环区间(Loop)试听、合成器发声以及实时电平表绘制,全部由浏览器本地基于 Web Audio API 的高精度音频时钟(AudioContext.currentTime)按拍数实时调度,做到零网络延迟的跟手操作。而像 YuE2 这样吃显存的整曲生成任务,则走异步作业队列交给云端后端。在线演示版本部署在 Qoder Sites 上,利用平台的无服务器函数能力作为轻量桥接层,把重负载推理转发给 Modal 的云端 GPU 容器。前端发起生成请求后,桥接层负责向 Modal 提交远端作业队列、持久化任务句柄、响应前端的状态轮询并支持随时下发取消指令,远端推理容器则固定运行在配置了 CUDA 环境的 NVIDIA L4 GPU 实例上。
双通道语音 Producer
做音乐和写代码有个很大的不同,编曲的时候人的注意力高度集中在听觉和视觉的同步上:眼睛得盯着时间轴上的播放头(Playhead)跨过小节线,耳朵得仔细分辨底鼓和贝斯有没有打架、过门的加花有没有抢掉主唱换气的空隙。如果这时候每次想改个细节都得停下播放、把手从监听控制器上挪开、切到侧边栏敲一大段字,创作的心流很容易被打断。Demotif 引入实时语音交互的初衷,就是希望人能把眼睛留在轨道上,耳朵听着循环播放的四小节乐段,嘴上直接像在录音棚里跟制作人商量一样说出修改意图。
在系统设计里,人发出的声音被严格分流到了两条职责完全不同的通道:一条是录音素材通道,对着麦克风唱出来的旋律或哼唱会经过延时补偿,直接录成时间轴上的音频源(Audio Asset)与对应的音频 clip,供后续切片、挪位置和挂混响;另一条则是 Producer 对话通道,专门用来商量编曲方案和下达修改指令。
在线上支持实时语音的部署环境里,Demotif 通过全双工 WebSocket 接入了阶跃星辰的 StepAudio 3 Realtime 端到端语音大模型,支持低延迟的连续语音流输入、语音流式回复以及随时开口打断(Barge-in)。为了兼顾实时对话的自然度与工程修改的严谨性,Producer 内部采用了双模型协同的分工架构:
- 实时语音通道负责交互与意图收敛:处理日常乐理问答、编曲建议探讨,并在用户边听边聊的过程中确认清楚到底要改哪几小节、动哪条轨道。
- 结构化文本 Producer 负责工程指令生成:一旦对话明确了需要对当前 DAW 工程动刀,系统就会将共享的会话历史与当前工程的结构快照(轨道列表、拍号、段落标记、选中区间)交给文本推理模型,由其生成严格符合 Schema 定义的结构化项目操作命令(Project Commands)。两边共享同一份会话上下文,切换起来毫无割裂感。
回到那个贯穿全文的场景:假设 Demotif 的工程里已经躺着一条独立的主唱音频轨,时间轴顶部标好了副歌(Chorus)的起始位置。你可以用鼠标在时间轴上框选副歌前的四小节,开启循环播放,然后直接开口对 Producer 说:给选中的这四小节加一条鼓轨,放一个鼓 clip。在四四拍的工程里,模型会自动算出这四小节对应十六拍的长度。你甚至可以在听着循环的同时顺嘴把要求提得更细,让它在一、三拍排底鼓,二、四拍排军鼓,第四小节最后一拍加个简短的十六分音符军鼓过门,顺便把军鼓的整体打击力度往回调一点,免得盖过主唱进副歌前吸气的声音。
非破坏性编辑与事务回滚
AI 助手能听懂人话只是第一步,敢不敢让它直接改你辛辛苦苦排好的工程,取决于底层的数据结构够不够健壮。Demotif 在工程状态管理上全面采用了资源与编排解耦的非破坏性设计,并引入了带版本校验的批处理事务机制。
在底层工程对象树里,轨道(Track)、片段(Clip)与底层资产(Asset)是三层分离的结构。每个排列在轨道上的 clip 内部只保存瘦元数据:它在时间轴上的起拍位置(startBeat)、持续拍长(durationBeats)、相对于源素材内部的起始偏移量(offsetBeats),以及一个指向底层音符集合(Note Pattern)或音频缓冲区(Audio Buffer)的引用 ID。这样一来,同一段四小节的基础鼓点 Pattern 可以被十几个 clip 引用并铺满整首歌,做切分或裁剪时也只是在改 clip 的边界参数,既省内存又不会污染源数据。
当文本 Producer 根据刚才的四小节加鼓需求生成修改方案时,它输出的是一组原子的领域命令序列,像是创建鼓轨、注册包含底鼓军鼓音符数据的 Pattern 资产、在目标轨道的指定起拍位置插入引用该资产的 clip。这组命令在真正写入前端状态机之前,必须闯过三道安全关卡:
- 工程并发锁(Project Lock):防止用户在时间轴上手工拖拽 clip 的同时,后台异步返回的 AI 命令同时篡改同一条轨道导致状态撕裂。
- 乐观锁版本号校验(Revision Check):每一批命令都绑定了生成该方案时的工程基准版本号,如果模型思考期间用户已经手动改过了工程,过期命令会被安全拦截。
- 结构与边界约束校验(Schema & Domain Validation):严格检查引用的轨道 ID 与资产 ID 是否存在、音符的音高与力度是否落在合法区间、起拍位置与时长是否为正数且对齐拍号网格。
只有全部通过校验,这一轮对话产生的所有修改命令才会被打包成一个原子事务(Transaction Batch),一次性写入当前的工程草稿态,并在撤销栈(Undo Stack)里压入一条对应的逆向快照。数据层面的合法性由校验器兜底,但音乐好不好听、律动对不对味,最终裁判永远是人的耳朵。
鼓 clip 自动落进那四小节之后,Web Audio 引擎在下一个循环周期就会把新鼓点和主唱一起播出来。听到第四小节末尾时,要是觉得 AI 排的那串过门加花塞得太满,还是有点抢主唱的气口,你完全不需要去翻什么历史记录手动删文件:觉得整段鼓思路不对,点一下撤销就能把这一整批新增的轨道、素材和 clip 干干净净退回原位;觉得大体律动挺好、只想微调结尾,既可以继续开口让 Producer 把第四小节最后一拍的军鼓抽掉两颗,也可以直接点开这个 clip 的鼓步进编辑器,用鼠标点掉两格军鼓,再把底鼓的力度滑块往下拉一点,视线不用离开时间轴,下一遍循环过来就能听到顺耳的过门。